





每个 Spring Boot 项目几乎都要写 CRUD,而原生 MyBatis 的痛点是:每个表要手写 Mapper.xml、重复的 resultMap、分页要自己写 count(*) 再拼 LIMIT、逻辑删除靠 WHERE deleted=0 处处粘贴。MyBatis-Plus(下文简称 MP)定位很明确——只做增强,不做改变:你原来的 MyBatis 代码一行都不用动,只是在上面叠了一层开箱即用的能力。本文聚焦 MP 自身,不重复讲 MyBatis 的 SqlSession/动态 SQL 原理,也不碰并发、集合、JVM 那些独立主题。
一、为什么需要 MyBatis-Plus先看一段原生 MyBatis 最常见的「样板代码」:
123456// 查询用户列表,按状态过滤 + 分页List<User> selectByStatus(@Param("status") Integer status, @Param("offset") int offset, ...
本文是大数据系列里的”存储格式层“补位篇:它讲的是 Iceberg 作为表格式(Table Format) 这一层——把对象存储上的文件变成一张可 ACID、可演进、可时间旅行的表。不重讲 Hive 的 HQL/数仓分层(hive-core 已铺开),也不重讲 Doris/ClickHouse 的 OLAP 内部原理(doris-realtime-datawarehouse、clickhouse-olap-practice 已铺开)。如果你困惑”湖和仓到底怎么统一”,这篇文章正好接上 Kafka/Spark/Flink/Hive/Doris 串起来的那条大数据链路。
一、为什么需要表格式?Hive 数仓的三道老伤在传统 Hive 数仓里,数据就是”对象存储/HDFS 上的一堆文件 + MetaStore 里记的表结构”。这种模式撑起了离线数仓,但越用越痛:
没有真正的 ACID:一次写入被打断,就留下半截脏文件;两个任务同时往一张表写,结果互相覆盖。
Schema 漂移、分区脆弱:改个列常常要 ALTER 还要重写数据;分区就是目录名,查询必须手写 WHERE dt='20 ...
本文是《Java I/O 与 NIO 实战》的”框架层续集”:不重讲 Buffer/Channel/Selector 三件套、也不重讲 mmap/sendfile 这类内核级零拷贝,那些在 NIO 篇已经铺开。这里只聊 Netty 在 NIO 之上多做了什么——如果你还没读 NIO 篇,建议先补一下”为什么一个 Selector 能管几万连接”。
一、为什么还需要 Netty?原生 NIO 的三道坎NIO 解决了”一个线程管几万连接”,但把 NIO 用在生产你会立刻撞上三道坎:
API 繁琐且易错:Selector、SelectionKey、ByteBuffer 的 flip/clear 稍不留神就数据错位;JDK 还存在著名的 epoll 空轮询 bug(Selector 唤醒却不返回就绪事件,CPU 100%)。
网络语义要自己兜底:断连重连、网络闪断、半包/粘包、读超时、写背压,全部得手写状态机。
线程模型要自己搭:Acceptor 与 IO 线程要不要分离?任务队列怎么排?业务阻塞怎么隔离?每一样都是坑。
Netty 把这三道坎全部封装掉,并且默认就规避了空轮询(用定时重 ...
前面写了 ClickHouse 实时 OLAP、Kafka 消息、Spark/Flink 计算、Hive 离线数仓、HBase 存储、ZooKeeper 协调——这套”采-存-算-协”链路里,还差一块:既能扛高并发点查、又能做实时多维分析的”服务化数仓”。ClickHouse 擅长大宽表聚合,但高并发点查和频繁更新是短板;Apache Doris 正好补上这个位置。本文把 Doris 的核心架构、数据模型、导入与查询优化一次讲透。
一、Doris 解决什么问题传统数仓有两个老大难:
场景
离线数仓(Hive)
纯 OLAP 列存(ClickHouse)
即席多维分析
慢(分钟级)
快,但高并发点查易抖
数据更新 / 覆盖
不便(重写分区)
弱(Mutation 异步)
高并发(几百 QPS 点查)
扛不住
非设计目标
上手成本
需 Hive/Spark 栈
需独立运维
Doris 的定位:一个兼容 MySQL 协议、MPP 架构、既适合实时多维分析又适合高并发点查 / 实时更新的实时数仓。它把”数仓”做成了一个可以直接被业务系统(报表、API、BI ...
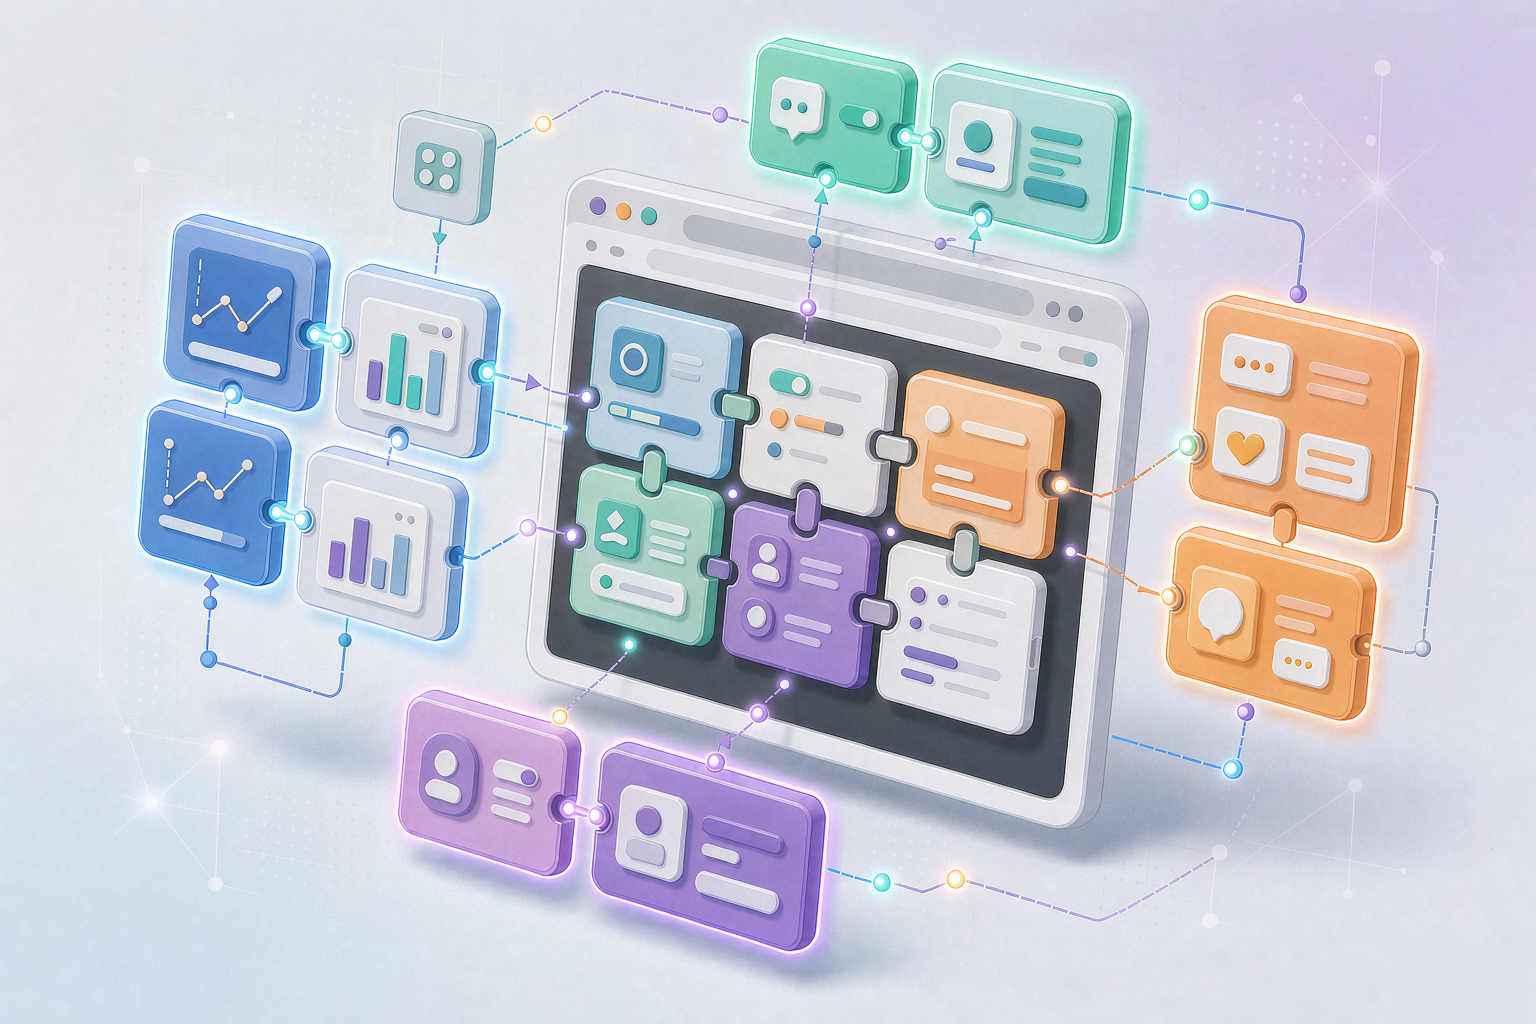
单体前端一旦膨胀到几十万行、十几个团队协作,技术栈升级要全员陪跑、一次发版全站停机、一个模块出错拖垮整站——这些痛点的根因是”构建时被强行打包成一个应用”。微前端的核心思路是:把一个应用拆成多个可独立开发、独立部署、运行时再组合的子应用。本文不聊某个框架的内部响应式(那部分 Vue3/React 已经写过),只聊”多应用如何共存”这件事。
一、为什么需要微前端传统 SPA 在规模变大后会出现三类典型困境:
巨石仓库:所有页面、所有团队挤在一个仓库里,依赖版本被强行统一,任何改动都要全量回归。
发布耦合:改一行也要走全站发版流程,无法做到”哪个团队改了哪个模块,就只发哪个模块”。
技术栈锁死:想从 Vue2 升级到 Vue3,或者引入 React,几乎不可能渐进式迁移,只能一次性重写。
微前端(Micro-Frontends)把”应用”拆成多个子应用,每个子应用拥有独立的技术栈、独立仓库、独立 CI/CD,在运行时由”基座(主应用)”把它们拼回一个完整的站点。
微前端 ≠ 组件库,也 ≠ 模块化打包。组件库解决的是”同一个应用内的复用”,微前端解决的是”不同团队、不同技术栈、不同生 ...
这是「Java 从入门到精通」系列的第 18 篇,也是收官篇。写到这里,语法、集合、并发、JVM 这些”知识点”其实都只是入场券——真正决定一个工程师上限的,是他能不能把代码稳定地、可复现地、可观测地交付出去。本篇按”构建 → 规范 → 测试 → 日志 → 调优 → 收官”的顺序,讲清工具背后的原理,而不是给你一份工具清单。建议配合前面的篇章一起读:知道了 HashMap 怎么扩容,才知道为什么要给集合预设初始容量;知道了 JIT 会消除死代码,才知道为什么 System.currentTimeMillis() 测出来的性能十有八九是假的。
一、工程结构与构建:从”能编译”到”可复现”1.1 坐标、依赖范围与依赖传递Maven 的一切都建立在坐标(GAV)之上。坐标不只是”下载地址”,它是构件的唯一身份;仓库(本地仓库、私服、中央仓库)本质是”坐标 → 构件文件”的映射表,而 Maven 的核心工作,就是把 POM 里声明的坐标解析成一棵依赖树,再按这棵树拼出 classpath。
真正容易被忽略、却天天在影响你的是依赖范围(scope):它决定依赖在哪些 classpath 生效、 ...
本文是「Java 从入门到精通」系列的第 17 篇,假定你已经掌握集合框架、泛型、异常与并发基础(对应本系列第(七)(十二)(十三)篇)。全文代码以 JDK 21 为准,涉及预览特性的部分会用 --enable-preview 标注。阅读建议:Lambda 与 Stream 两章请务必动手跑一遍代码,尤其是 peek 不执行、流一次性消费、toMap 键冲突这三个坑,只有亲眼见过异常栈才会真正记住。
一、版本演进全景:从 Java 8 到 Java 212014 年发布的 Java 8 是 Java 历史上最重要的分水岭:它把函数式编程正式引入 Java 语法,Lambda、Stream、默认方法、新的日期时间 API 四件套同时落地。此后 Oracle 改为六个月一个版本的发布节奏,每两年挑一个版本作为 LTS(长期支持版)。到今天,Java 8 已经全面停止免费商业支持,而 Java 21 成为新一代的主流基线。
1.1 关键特性时间线
版本
发布时间
LTS
关键特性(各取 2-3 个)
Java 8
2014-03
是
Lambda 表达式、Stream API ...
本文默认读者已掌握 Java 基础与多线程,JVM 以 HotSpot 为主,JDK 横跨 8 / 11 / 17 / 21,会明确标注版本差异——尤其是 GC 日志格式(JDK 9 前后完全两套)与默认收集器的变更。建议边读边跑第五节的日志实验与第七节的 CPU 飙高实验:调优从来不是背参数,而是”看到数据—提出假设—小步验证”的闭环。
一、GC 到底要解决什么问题1.1 为什么不是引用计数判断对象”还活着没有”,最朴素的想法是引用计数(Reference Counting):每个对象维护计数器,有人引用 +1,失效 -1,归零立刻回收。Python、PHP、Objective-C ARC 都用这套方案,实现简单、回收及时。但它有致命缺陷——无法处理循环引用,两个对象互相持有对方时计数永远不为 0;且每次赋值都要改计数器,多线程下还要保证原子性。HotSpot 因此放弃了它。
123456789101112131415161718192021/** * 演示循环引用:在引用计数方案下这两个对象永远不会被回收。 * HotSpot 使用可达性分析,因此 GC 后它们会被正常回收。 * ...
Kafka 篇讲过 Broker 元数据、HBase 篇讲过 RegionServer 上线——这两个系统背后其实都站着同一个”协调员”:ZooKeeper。分布式系统里最麻烦的不是算,而是多台机器对”谁说了算、配置改没改、锁归谁拿”达成一致。本文把 ZooKeeper 最核心的四块:ZNode 数据模型、Watch 机制、集群读写流程、ZAB 协议一次讲透,并给出分布式锁/选主的正确落地姿势与生产避坑清单。
一、为什么需要协调服务单机时代不存在的问题,到了分布式时代全冒出来了:
经典难题
具体表现
ZooKeeper 提供的原语
谁是主
主挂了,多台备机同时认为自己是主(脑裂)
临时节点 + 顺序节点 + Watch → 选主
配置同步
改一份配置要登录 N 台机器,改漏一台就出事故
ZNode 存配置 + Watch 推送变更
互斥锁
多个进程同时改同一份数据,谁先谁后?
临时顺序节点 → 分布式锁
集群成员管理
某台机器”假死”,它的任务资源怎么释放?
临时节点:会话断开自动删除
命名/寻址
服务实例动态上下线,调用方怎么感知?
顺序节点 + W ...
本篇属于 进阶向硬核内容。文中所有代码均在 JDK 17(HotSpot 64-Bit Server VM) 上验证过,涉及 JDK 8 / 11 / 21 差异的地方会单独标注。想真正吃透,请把示例代码敲一遍,尤其是对象布局与自定义类加载器那两段。
写在前面:为什么要学这一块很多同学写 Java 三五年,对 JVM 的认知停留在「堆放对象、栈放局部变量、方法区放类信息」。这三句话没错,但粗到无法支撑下面这些问题:8C16G 的容器 -Xmx 该设多大(设小了频繁 Full GC、设大了被 OOMKilled);一个 new Object() 在 64 位机器上占几个字节;为什么 -Xmx 还剩一大截却抛 Metaspace 的 OOM;Tomcat 里两个 WebApp 各引一个不同版本的 Spring 为什么不打架。答案全在运行时数据区和类加载子系统里。
一、JVM 整体架构:规范与实现的分野1.1 一个必须厘清的前提:规范不等于实现《Java Virtual Machine Specification》定义的是抽象行为契约:Class 文件格式、字节码指令集、运行时数据区、类加 ...